
Netlifyは、自社ブログで、同一プロンプトを11種類のAIモデルに実行する実験記事を公開しました。
Netlify Agent RunnersとAI Gatewayを使い、モデルごとの結果とコストを比較しています。
平均消費クレジットは2.4〜519でした。両端を比べると、約216倍の開きがあります。
企業にとっては、最上位モデルを一律に使う運用を見直す材料になります。
品質だけでなく、タスクと予算に合わせたモデル選定が重要です。
※本記事は2026年8月24日時点の情報です。
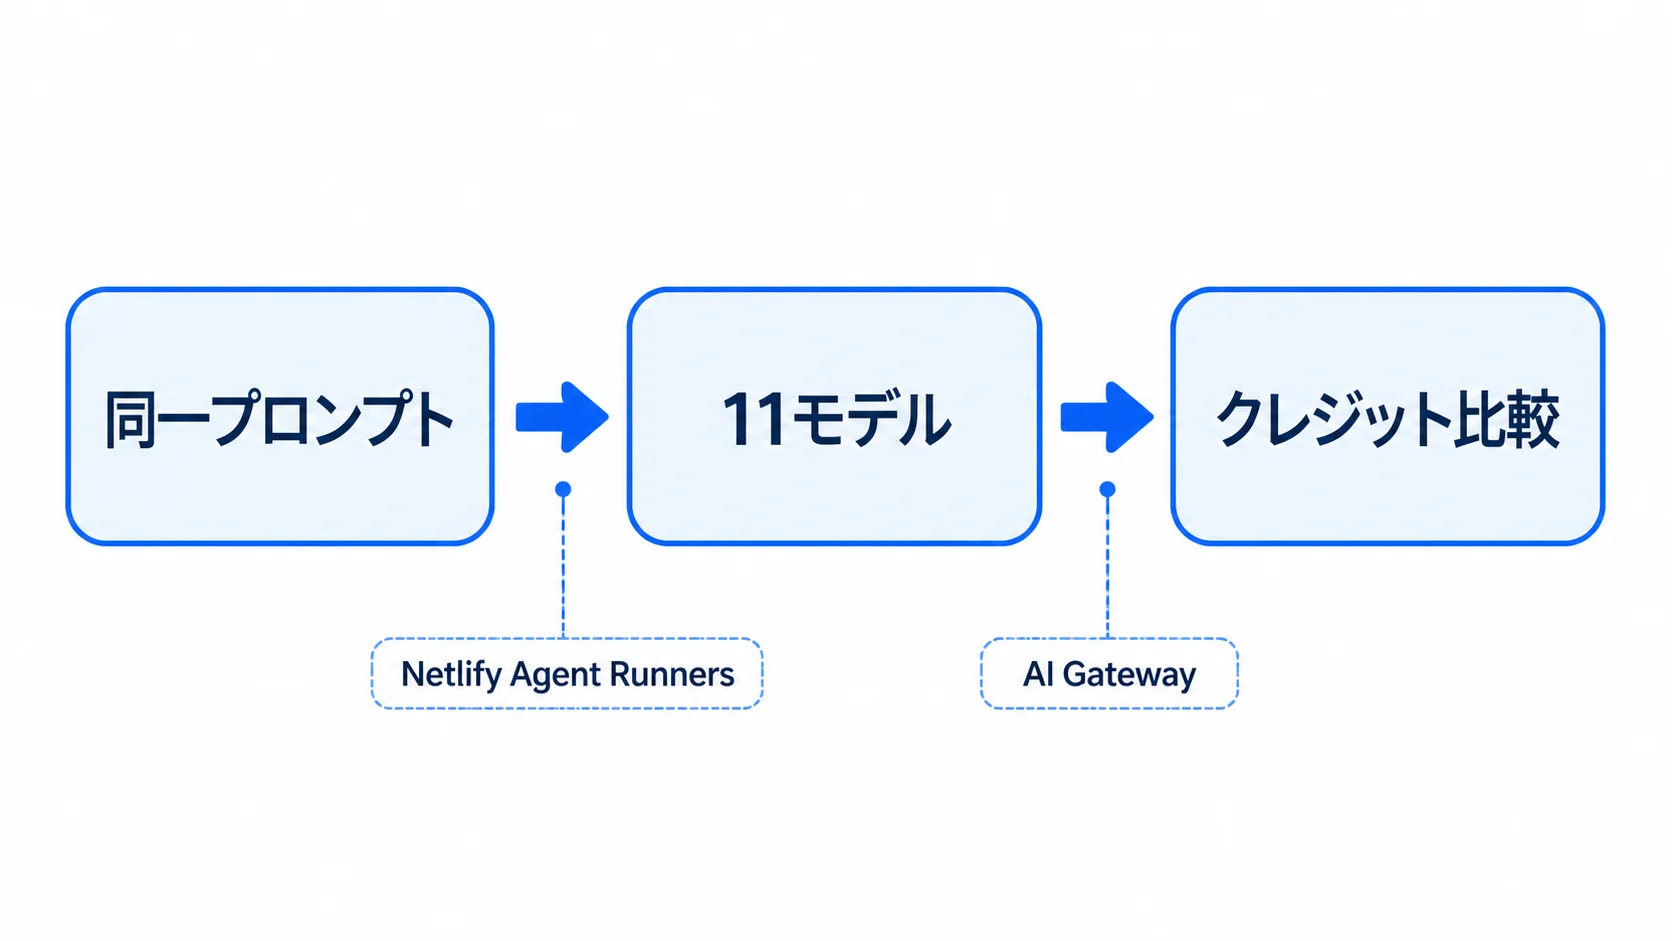
実験の仕組み|同一プロンプトを11モデルで実行
Netlifyの実験は、自社ブログ記事で公開されています。
実行環境は、チャット形式のプロンプトボックスからエージェントを動かすNetlify Agent Runnersです。
モデルへのアクセスには、OpenRouterとのパートナーシップを使うNetlify AI Gatewayが使われました。
同じプロンプトで試したユースケースは、次の3種類です。
- 近所のコーヒーショップ向け1ページサイトの構築
- マルチユーザー対応ToDoリストアプリの構築
- AIベースのレシピ提案ウェブアプリの構築
例示プロンプトは、近所のコーヒーショップ向けに1ページサイトを作る指示でした。
営業時間、住所、短いメニュー、写真を含める内容です。
同じ入力を使うことで、モデルを変えたときの消費量を比べています。
モデルの自動評価には、AXISというツールが使われたと記載されています。
ポイント
Netlifyは、3種類の開発タスクを同じプロンプトで11モデルに実行しました。Agent RunnersとAI Gatewayを通じた比較です。
結果|平均2.4〜519クレジットで約216倍差
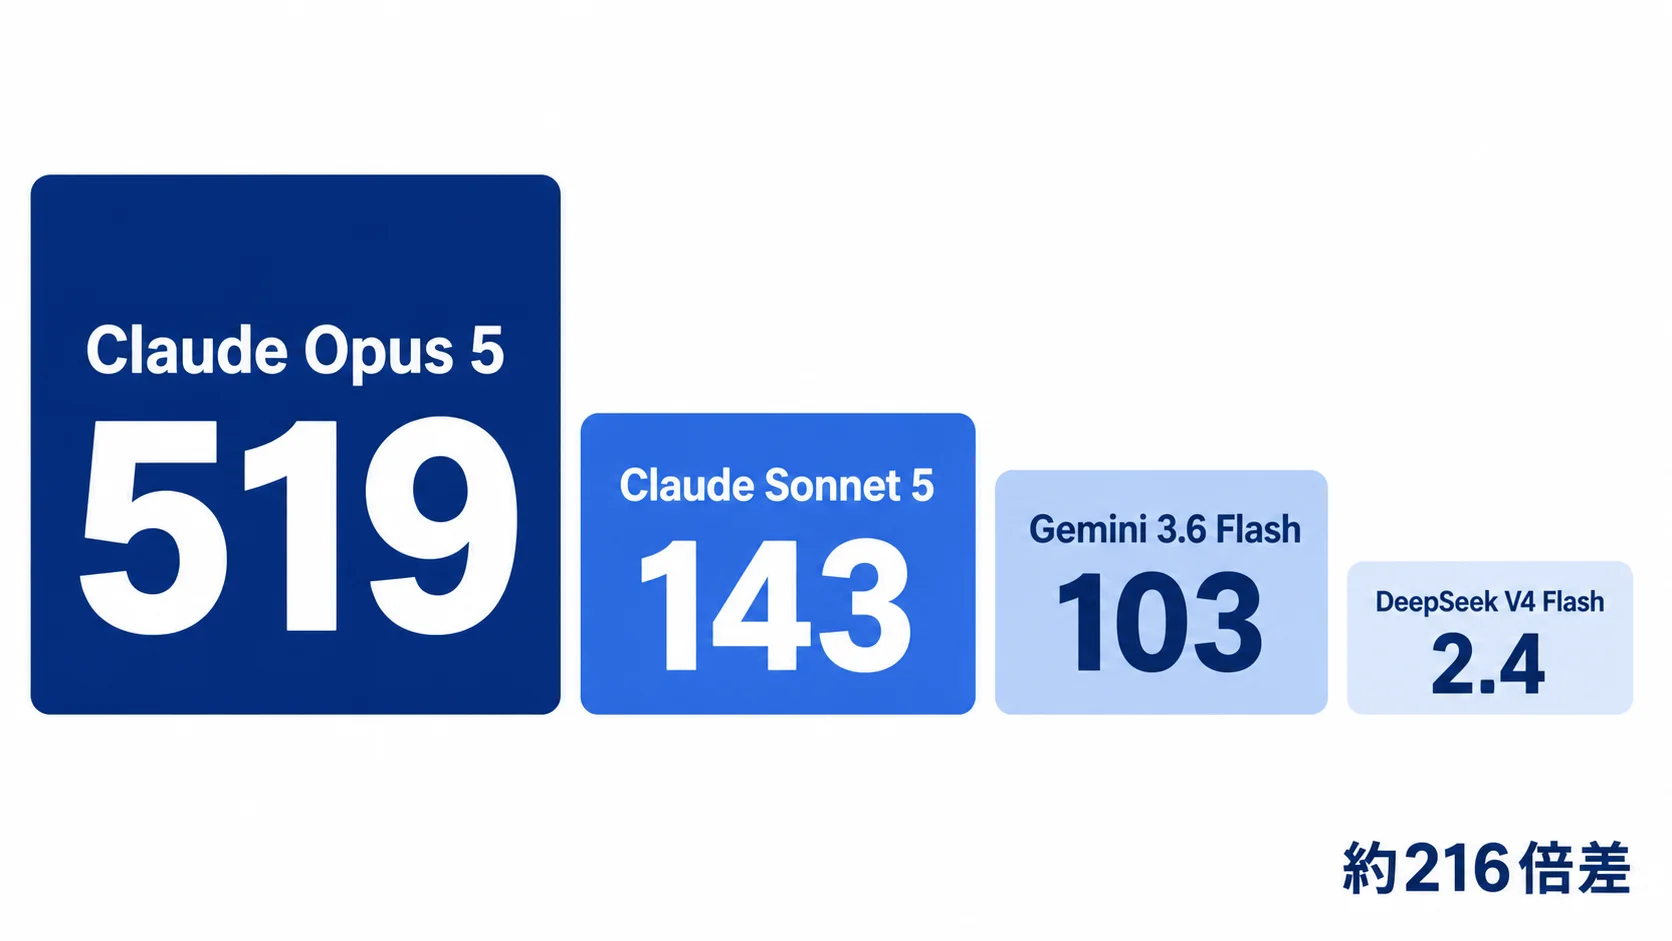
Netlifyブログに掲載された平均消費クレジットは、次のとおりです。
| モデル | 平均クレジット | 個別実行値(3回) |
|---|---|---|
| Claude Opus 5 | 519 | 253・249・1,055 |
| Claude Sonnet 5 | 143 | 81・245・103 |
| GPT 5.6 Sol(low effort) | 141 | 173・158・92 |
| Gemini 3.6 Flash | 103 | 109・91・111 |
| Kimi K3 | 102 | 125・95・86 |
| Gemini 3.1 Pro | 53 | 57・52・49 |
| GPT 5.6 Terra | 39 | 43・23・49 |
| DeepSeek V4 Pro | 37 | 47・30・33 |
| GLM 5.2 | 27 | 15・42・24 |
| Kimi K2.7 Code | 19 | 21・18・17 |
| DeepSeek V4 Flash(0731) | 2.4 | 3.4・1.3・2.5 |
表の個別実行値は、各モデルについて3回分が並んでいます。
平均クレジットは、その3つの値をもとにした掲載値です。
Claude Opus 5は、253・249・1,055で、平均519でした。
DeepSeek V4 Flash(0731)は、3.4・1.3・2.5で、平均2.4でした。
最高値はClaude Opus 5の519クレジットです。
最低値はDeepSeek V4 Flash(0731)の2.4クレジットです。
519を2.4で割ると約216.25倍です。記事では約216倍の差として示されています。
クレジットの定義と円換算
クレジットは、Netlifyの料金プランで利用量を管理する単位です。
- Freeプラン:300 credit limit
- Personalプラン:1,000 credits(included)
- Proプラン:3,000 credits(included)
- Enterprise:Unlimited
- Personal向け追加パック:500 creditsで$5
- Pro向け追加パック:1,500 creditsで$10
料金の詳細は、Netlify公式料金ページに掲載されています。
Pro向けパックでは、$10÷1,500 creditsから1クレジット約$0.00667と算出できます。
※1ドル=150円で換算すると、1クレジットは約1円です。
この約1円は、料金ページの明記額ではなく、追加パックからの算出値です。
Freeプランには300の上限があり、PersonalとProには一定量が含まれます。
EnterpriseはUnlimitedとされ、プランによって管理方法が異なります。
追加パックの価格は、利用量を予算へ置き換えるときの基準になります。
ポイント
今回の平均値は2.4〜519クレジットで、約216倍の差がありました。約1円という換算は、Pro向け追加パックから算出した参考値です。
著者の結論|予算に応じて一括型か反復型かを選ぶ
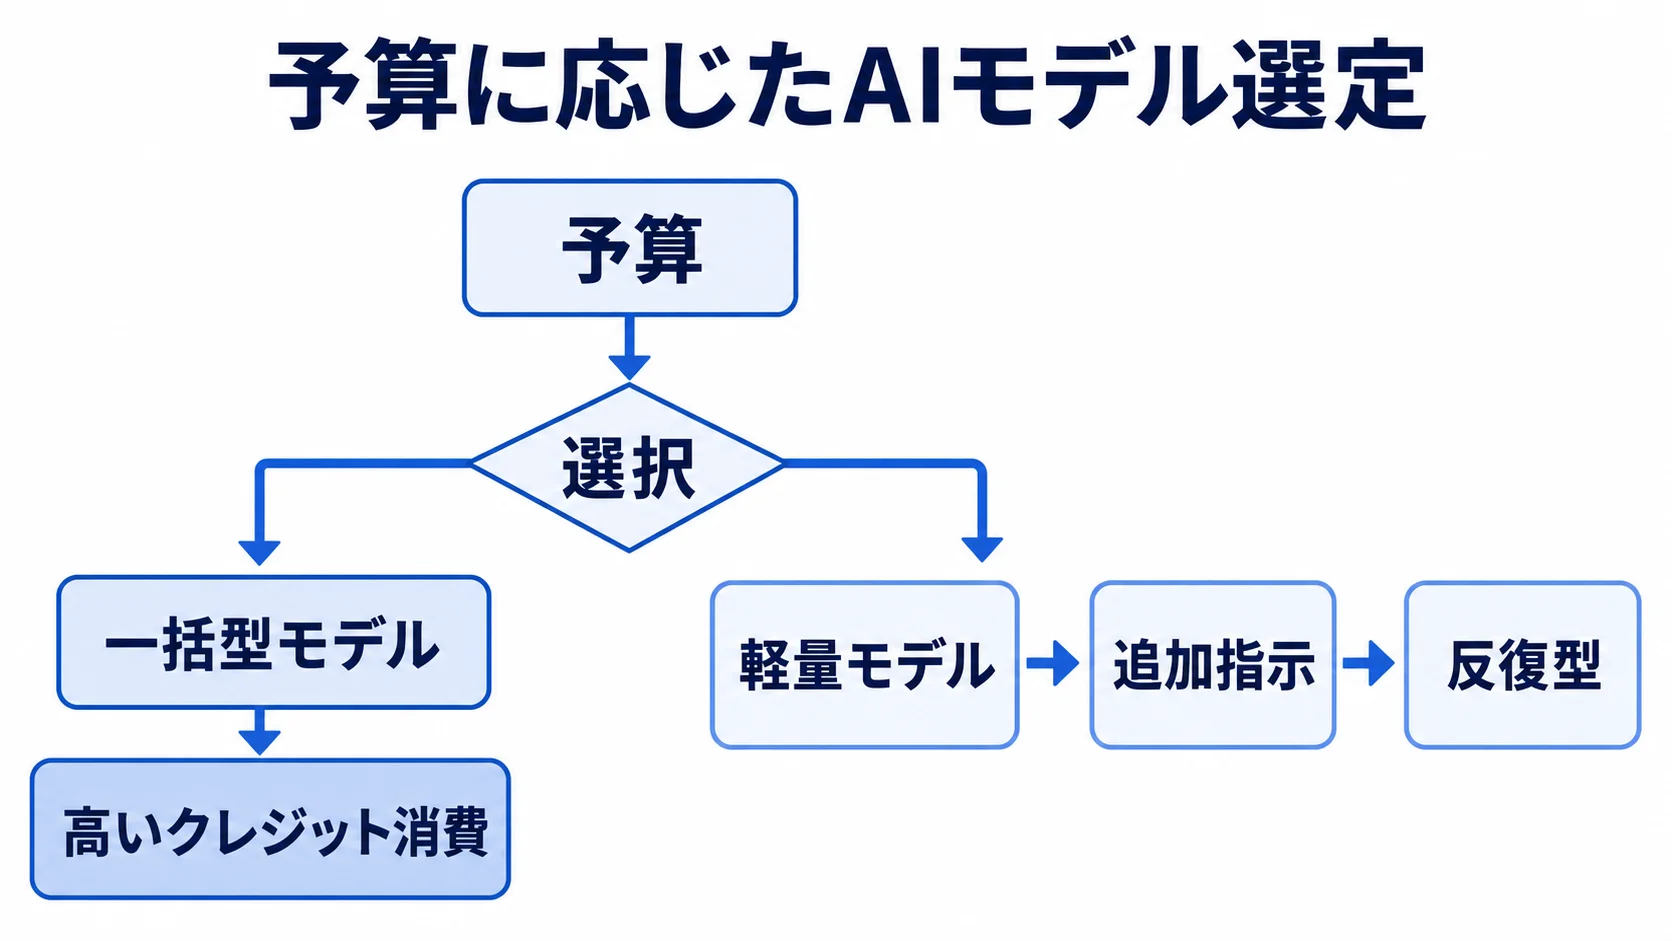
Netlifyの著者は、限られた予算での選択肢を問いかけています。
一つは、事前に多くを計画して処理する一括型の解決策です。
もう一つは、より単純なモデルへ追加指示を重ねる反復型です。
予算が限られるなら、どちらを選ぶかが著者の中心的な問いです。
実験全体の論調は、高コストが高品質を意味するとは限らないというものです。
高いクレジット消費を選ぶかは、予算と作業の進め方で変わります。
一括型は、最初の指示で多くを任せたい場面の選択肢です。
反復型は、出力を見ながら追加指示で調整する場面の選択肢です。
ただし、これは今回の実験結果の範囲で読む必要があります。
ポイント
Netlifyの問いは、高機能な一括型モデルと、軽量モデルへ追加指示を重ねる反復型の比較です。安価なモデルが常に優れるという結論ではありません。
Hacker Newsの論点|評価方法と実務適用をめぐる賛否
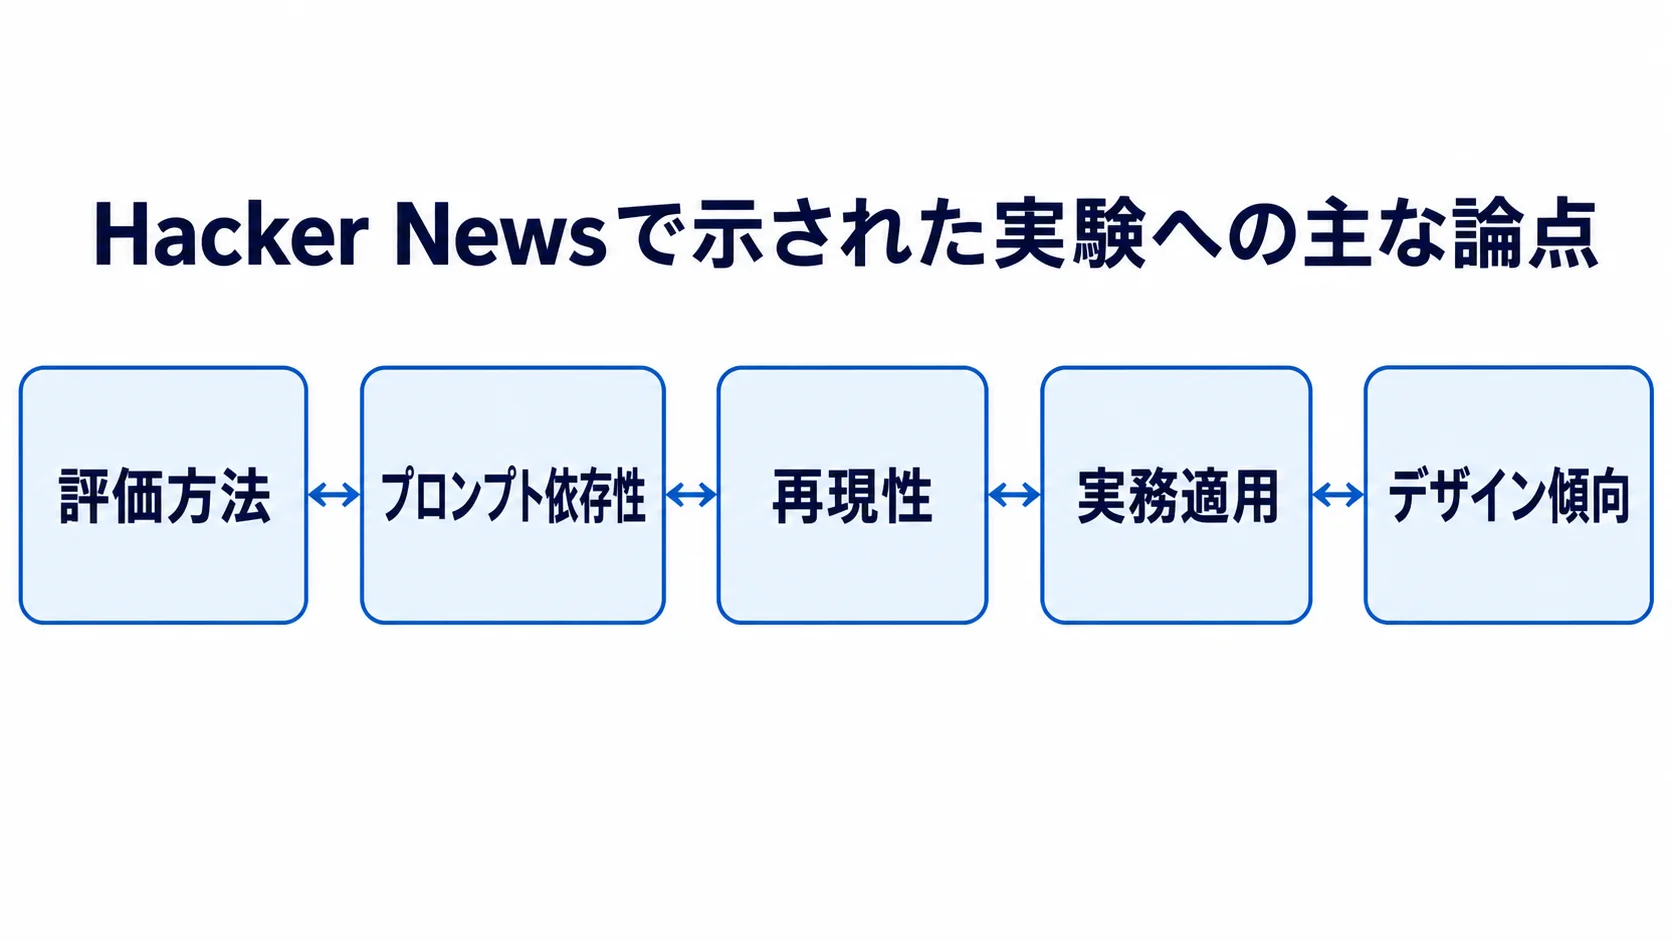
Hacker Newsには、この実験をめぐる議論が投稿されています。
投稿日時は2026年8月13日です。
2026年8月24日時点で、220 points、95 commentsでした。
Hacker Newsの投稿では、主に次の論点が示されています。
- 評価方法への疑問:3回の実行だけでは、ばらつきや比較の妥当性を判断しにくいという指摘です。
- プロンプト依存性への反論:簡潔な指示では平均的な応答になり、詳細な指示で差が出るという見方です。
- 再現性への懸念:同じモデルでも、実行時期や条件で結果が変わる可能性が論じられました。
- 実務適用への懐疑:実際の開発は反復的で、単発の比較は代表性に乏しいという意見です。
- デザイン傾向の観察:モデルの学習傾向が、初期のデザイン選好に影響するのではという指摘です。
評価方法への疑問は、数値を見るときの前提条件に関わります。
プロンプト依存性への反論は、同じモデルでも指示の細かさで見え方が変わるという論点です。
再現性への懸念は、1回の比較値を固定的な性能とみなさない見方につながります。
HNでは、比較結果を考える材料とみる意見と、単発評価の限界を重くみる意見が並びました。
企業がHNの論点を参考にするなら、比較条件を記録することが先になります。
プロンプトの内容、対象タスク、モデル名、消費クレジットを同じ形式で残します。
その記録があれば、単発の数字と継続運用の数字を分けて考えられます。
ポイント
HNの議論は、コスト差そのものだけでなく、プロンプト・再現性・反復開発との関係も問いました。数値を自社判断へ移すには、利用条件の整理が必要です。
企業への含意|モデル選定とコスト管理を分けて考える
企業が見るべき第一の点は、同じタスクでもモデルごとに費用が変わることです。
最上位モデルを標準設定にすると、利用量が大きく膨らむ可能性があります。
実務上の示唆として、モデル選定とコスト管理を次のように分けます。
- タスク別に選ぶ:必要な精度とクレジット予算を、業務ごとに整理します。
- 利用量を測る:同じタスクを複数モデルで試し、平均消費クレジットを比べます。
- モデルを使い分ける:タスクの複雑さに応じたモデルルーティングを検討します。
- 反復型も比べる:一括処理と、追加指示を重ねる運用を比較します。
モデルルーティングは、すべての処理を同じモデルへ送らない考え方です。
単純な処理と複雑な処理で、候補モデルや許容コストを分けて考えます。
導入前には、代表的なタスクを選び、同じプロンプトで消費量を記録します。
その結果を、必要な精度と予算の両方から見直します。
モデル選定では、費用だけを単独の評価軸にしないことも大切です。
Netlifyの著者も、安価なモデルの採用だけを結論にしていません。
一括型と反復型を、チームの作業手順に合わせて比べる視点を示しています。
予算上限を決めるときは、モデル単価だけでなく、1タスクの消費量を見ます。
同じ業務でも、指示の出し方によって反復回数と利用量は変わり得ます。
そのため、モデルの候補と運用手順を一緒に比較することが実務的です。
比較結果は、利用者が選択理由を説明する材料にもなります。
料金改定を含めたコストの見方は、GPT-5.6の料金改定の記事も参考になります。
モデル選定の整理では、Claude Opus 5の料金と選定ポイントも関連します。
この実験が示すのは、単一の勝者ではなく、選び方を設計する必要性です。
ポイント
企業は、タスクごとの必要精度・利用量・予算を見ながらモデルを選ぶ必要があります。高コストモデルの一律利用を避け、使い分けと反復型の運用を比較することが実務上の示唆です。
よくある質問(FAQ)
Q. Netlifyの実験では何を比較しましたか?
同一プロンプトを11種類のAIモデルに実行し、結果と消費クレジットを比較しました。
Q. 消費クレジットにはどれほど差がありましたか?
平均値は2.4〜519クレジットでした。最高値と最低値には約216倍の差があります。
Q. 1クレジットは何円ですか?
Pro向け追加パックからの算出では、1クレジットは約1円です。公式の明記額ではありません。
Q. Hacker Newsへの投稿はいつですか?
投稿日時は2026年8月13日です。2026年8月24日時点で220 points、95 commentsでした。
まとめ
Netlifyの実験では、同じプロンプトでも11モデルの平均消費クレジットに大きな差が出ました。
企業は、品質とコストを一つの順位で決めず、タスク・予算・反復方法に合わせて選ぶことが重要です。
比較の出発点は、利用したい業務と許容できるクレジット量を決めることです。
その条件に合わせて、複数モデルと一括型・反復型の運用を比べます。
導入後も利用量を確認し、予算と選定条件を必要に応じて見直します。
自社の運用条件等に照らし、継続的に判断できる形へ整えます。
ポイント
約216倍のコスト差は、モデルを固定する前に比較する理由になります。自社タスクで利用量を測り、モデルの使い分けと運用方法を設計しましょう。
関連記事
- DeepSeek V4を解説|Pro・Flashの仕様とAPI料金、企業導入のポイント
- Gemini Enterprise Agent Platformを解説|企業向けエージェント基盤の機能と運用ポイント
- Grok 4.5を解説|性能・料金とコーディングでの活用ポイント
- Copilot in ExcelのOpus 5・GPT-5.6対応を解説|表計算でのAI活用ポイント
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。